与 Antaripa Saha 合著。 决策模型最近异军突起,首先是 TypeSafe 的 Jev,接着是 Perplexity 的 Decider、Liquid 的 d1、Cloudflare 的 Clef 以及 OpenAI 的 Decisions API。这些模型承诺提供快速且廉价的分类。
对于自动化评估而言,决策模型是 LLM 评判器的一种极具吸引力的低成本替代方案。但它们是否是正确的选择,取决于你具体用例的成本、性能和延迟要求。
我们还注意到,人们在使用 0.50 的默认决策阈值时,并没有检查它是否适合他们的任务。这可能会错失大量性能。
在这篇文章中,我们将首先展示如何调整阈值以从决策模型中获得最佳结果。在调整好阈值后,我们将比较成本和性能,以帮助你评估哪种模型适合你的用例。最后,我们将探讨在决定是否采取行动时如何解释模型分数,以及校准如何使它们作为置信度估计更具实用性。
下方的图表为静态预览。为了获得最佳阅读体验,我建议在 hamel.dev 上阅读本文,你可以在这里探索交互式图表。
我们测试了什么
我们使用了来自公寓租赁代理的 100 条轨迹,即对话和操作的日志。任务是识别包含错误的轨迹,例如预订失败或遗漏了向人工的交接。我们在之前关于自动化评估的文章中使用了相同的数据集和广泛的故障查找任务。在这里,每个决策模型都会为每条轨迹返回一个故障概率。
我们测试了 Jev 1.13、Perplexity Decider 1.1 27B、Liquid d1 和 d1-ultra、Cloudflare Clef Flash 以及 OpenAI Decisions (GPT-6 Luna)。每个模型都收到了相同的评估标准。附录展示了提示词以及 Jev 使用的结构化版本。
我们从两个维度比较模型:
- 性能:我们将每个模型的预测与人工审核并标记为通过或失败的轨迹进行比较。这衡量了模型在避免误报的同时捕获故障的能力。
- 成本:我们根据 token 使用量和提供商的价格计算 API 成本。
为简洁起见,我们将延迟放在一边,因为它取决于本实验无法控制的因素。
理解决策阈值
我们为每条轨迹分配通过或失败两个标签之一。这是一个二元的通过/失败评估,我们推荐这种做法,因为它能鼓励制定清晰的标准,并且更容易与人类偏好保持一致。
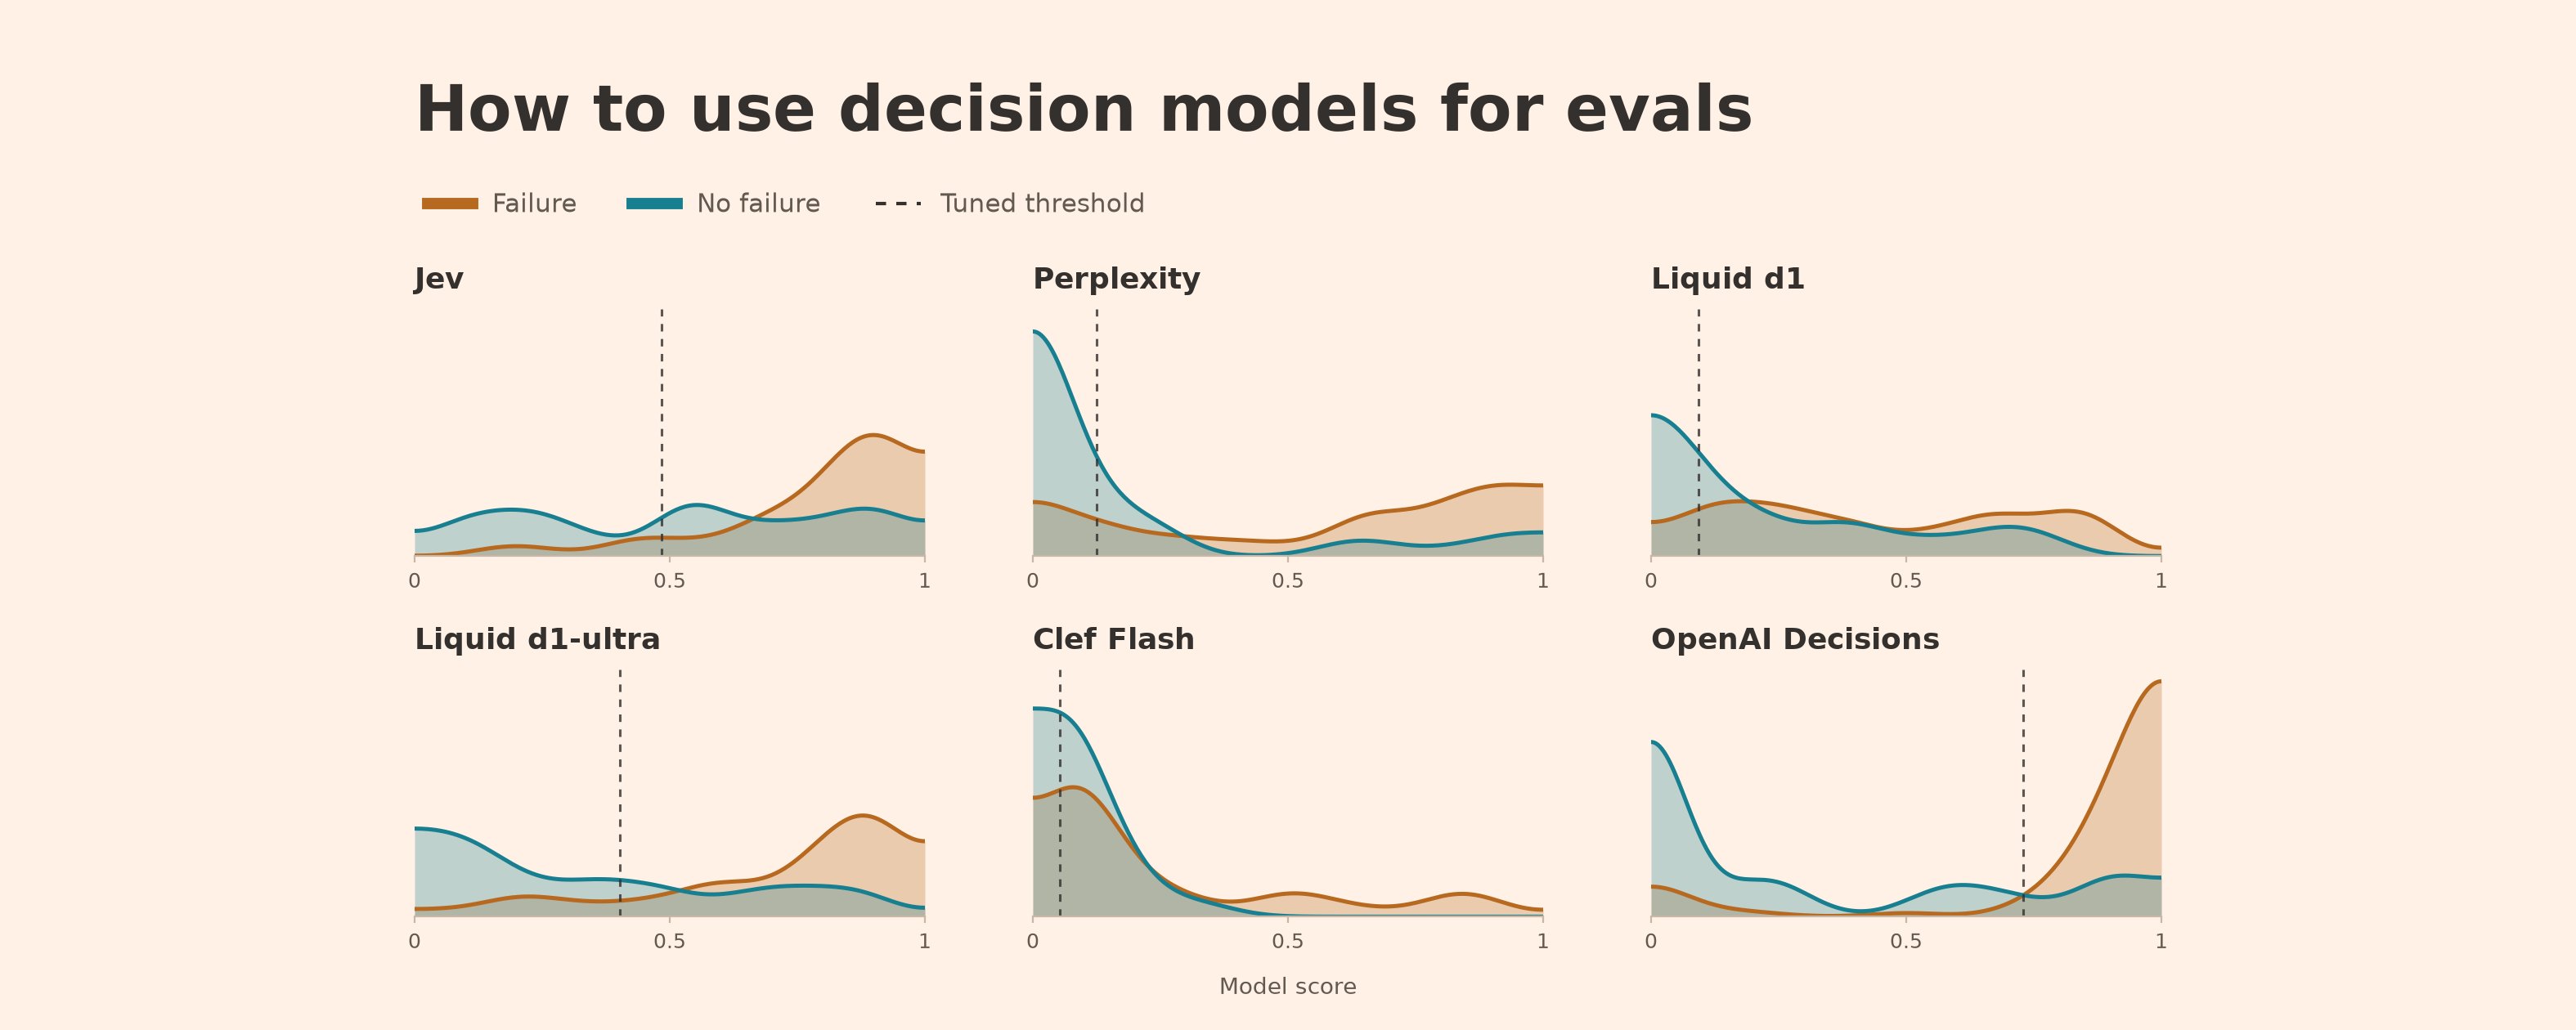
每个决策模型都会返回一个 0 到 1 之间的分数,用于估计轨迹包含故障的可能性。API 使用 0.50 的默认决策阈值将这个分数转化为决策。分数达到或超过阈值的轨迹会被标记为故障。在不根据你的数据检查的情况下使用此默认值,可能会给你带来平庸的结果。
例如,一个模型可能会给每个失败项打 0.40 分,给每个通过项打 0.10 分。尽管这个模型在 0.30 的阈值下能完美分类轨迹,但 0.50 的默认阈值将什么也抓不到。
在实践中,失败和通过轨迹的分数会有重叠。降低阈值可以捕获更多故障,但也可能引发更多误报。选择阈值意味着要平衡:
- 精确率:包含已知故障的被标记轨迹的比例。
- 召回率:模型捕获的已知故障的比例。
正确的权衡取决于你的业务目标。例如,刑事审判对定罪设定了高标准,以避免冤枉无辜的人,这强调了精确率。癌症筛查可能强调召回率,接受更多误报以减少漏诊病例。在本次比较中,我们将使用 F1 分数(即两者的调和平均数)赋予精确率和召回率同等的权重。F1 分数范围从 0 到 1,越高越好。
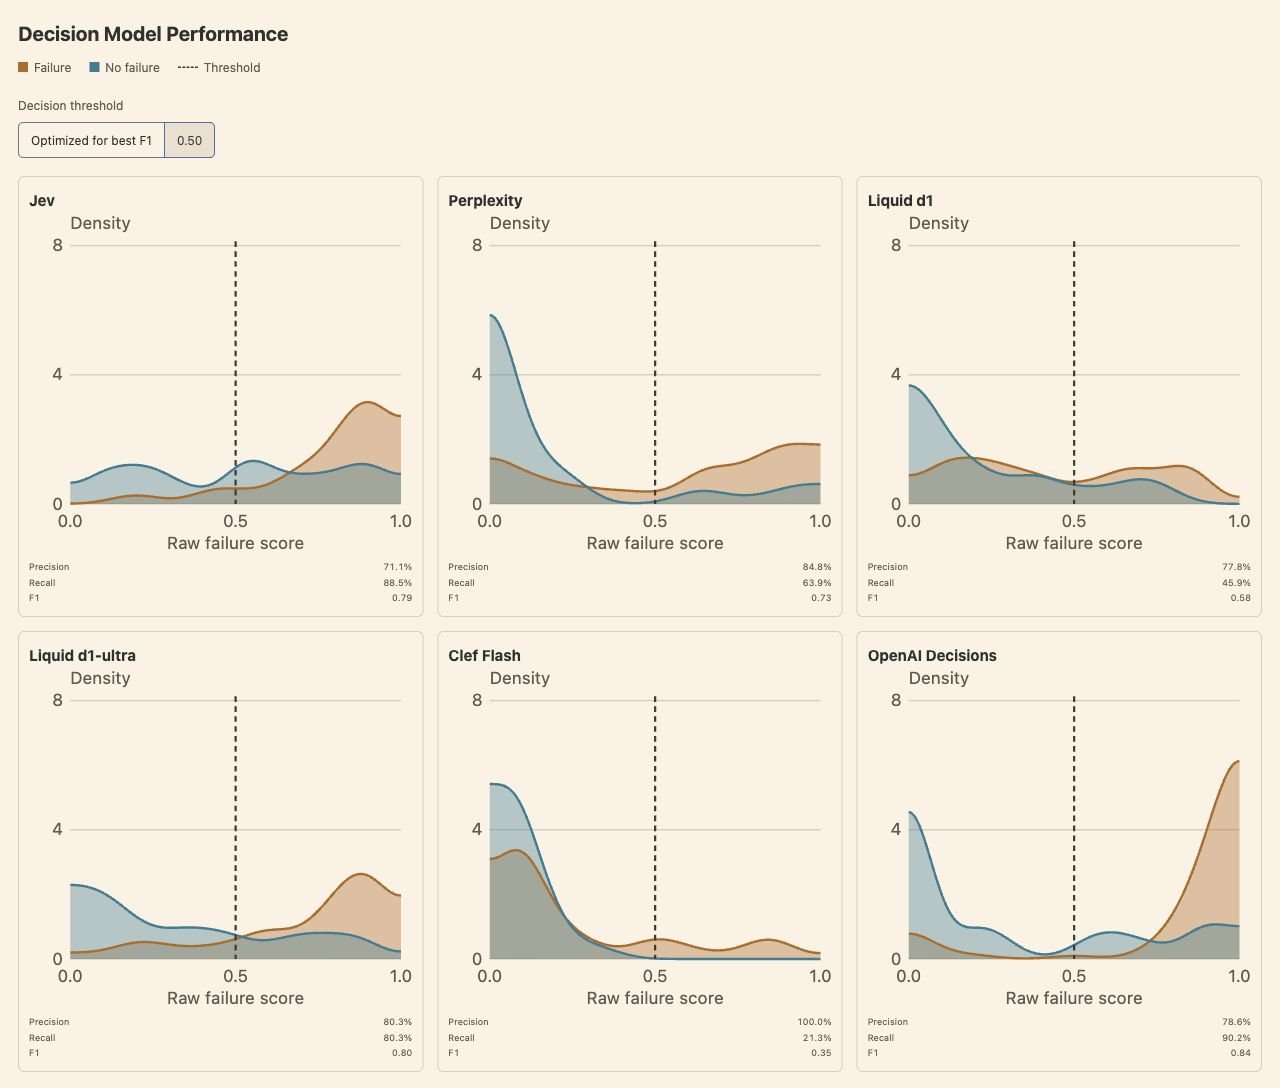
下方的曲线展示了每个模型如何对失败轨迹(橙色)和通过轨迹(蓝色)进行评分。曲线较高的部分意味着该类别的更多分数落在该范围内。达到或超过虚线阈值线的分数将被标记。使用切换按钮比较 0.50 与“为最佳 F1 优化”,后者会为每个模型选择一个阈值。
Explore the interactive chart on hamel.dev
OpenAI 在此任务上最好地分离了这两个类别,这也反映在其较高的 F1 分数上。
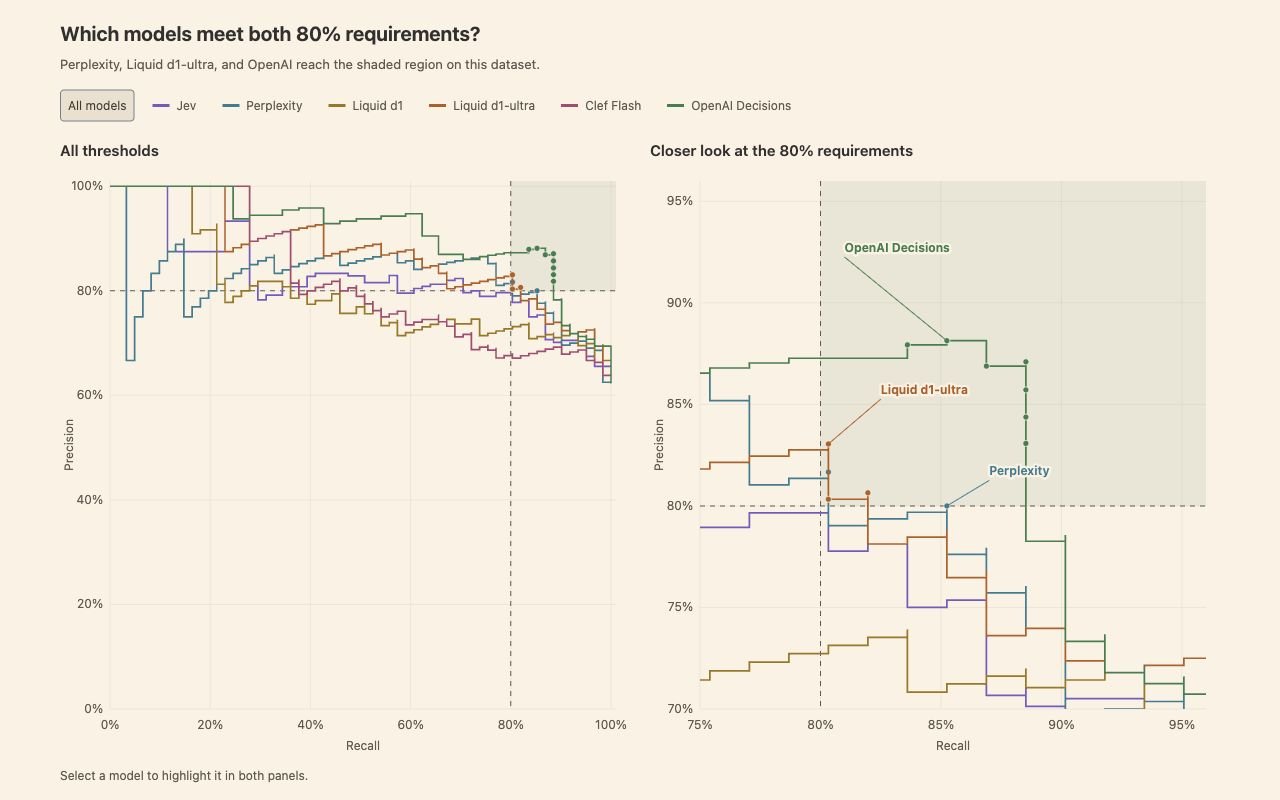
同样重要的是,不要盲目追求 F1 最大化,而不考虑分类器要发挥作用所需的最低要求。例如,如果此分类器用于自动警报系统,我会希望精确率和召回率都至少达到 80%,以便在捕获足够数量故障的同时尽量减少误报。
下方的图表展示了精确率和召回率在不同阈值下的变化情况。阴影区域标志着两者都至少达到 80% 的范围。
Explore the interactive chart on hamel.dev
Perplexity、Liquid d1-ultra 和 OpenAI Decisions 满足了我们的要求,但我们仍然需要在阴影区域内为每个模型选择一个决策阈值。在下一节中,我们将讨论如何调整这些阈值。
调整决策阈值
在这个例子中,我们将优化 F1 分数。对于我们的候选模型,我们将尽可能把调整限制在训练数据上同时满足 80% 最低要求的阈值内。我们让其他模型不受约束,以说明调整的效果。
有了标记好的轨迹和保存的模型分数,你就可以让编程代理来调整阈值。以下是一个示例提示词,你可以根据自己的用例进行修改:
Using my saved model scores and binary labels (1 means failure), tune a decision threshold to maximize F1 while requiring at least 80% precision and 80% recall. Use stratified five-fold cross-validation, choosing thresholds on the training examples and measuring performance on the remaining examples. If comparing models, use the same splits for each. Only select thresholds that meet both minimums on the training examples. If none qualifies, report that rather than relaxing either requirement. Report validation precision, recall, and F1, along with any splits where no threshold qualified or validation performance fell below my minimums. Compare with the default threshold of 0.50. Reuse the saved scores without making new model calls.
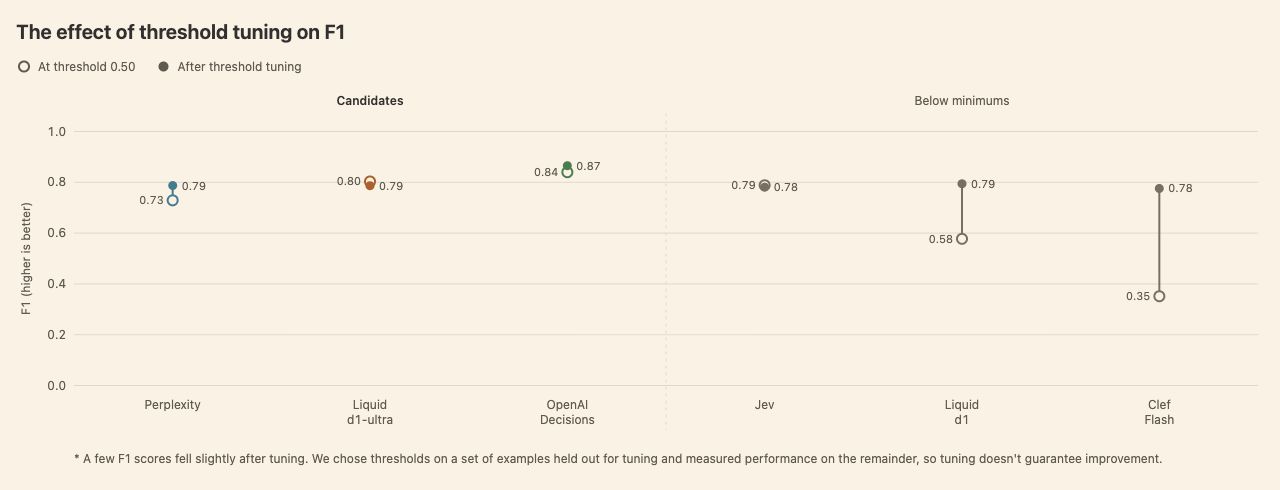
以下是为 F1 进行调整后每个模型性能的变化。我们将精确率-召回率图表中的三个候选模型组合在一起,并以灰色显示其他模型,以说明调整能带来多大帮助。
Explore the interactive chart on hamel.dev
我们的候选模型从 F1 调整中获得的收益不如 Liquid d1 和 Clef Flash 大,后两者未达到我们的最低要求。然而,即使是精确率和召回率的微小变化也会影响业务成本或用户体验,因此要有目的地选择权衡。在实践中,精确率和召回率不太可能同等重要(正如我们在本文中假设使用 F1 那样)。例如,F-beta 分数允许你在 beta 低于 1 时赋予精确率更高权重,或在 beta 高于 1 时赋予召回率更高权重。优化不同的指标可能会导致不同的阈值和结果。
性能与成本的对比
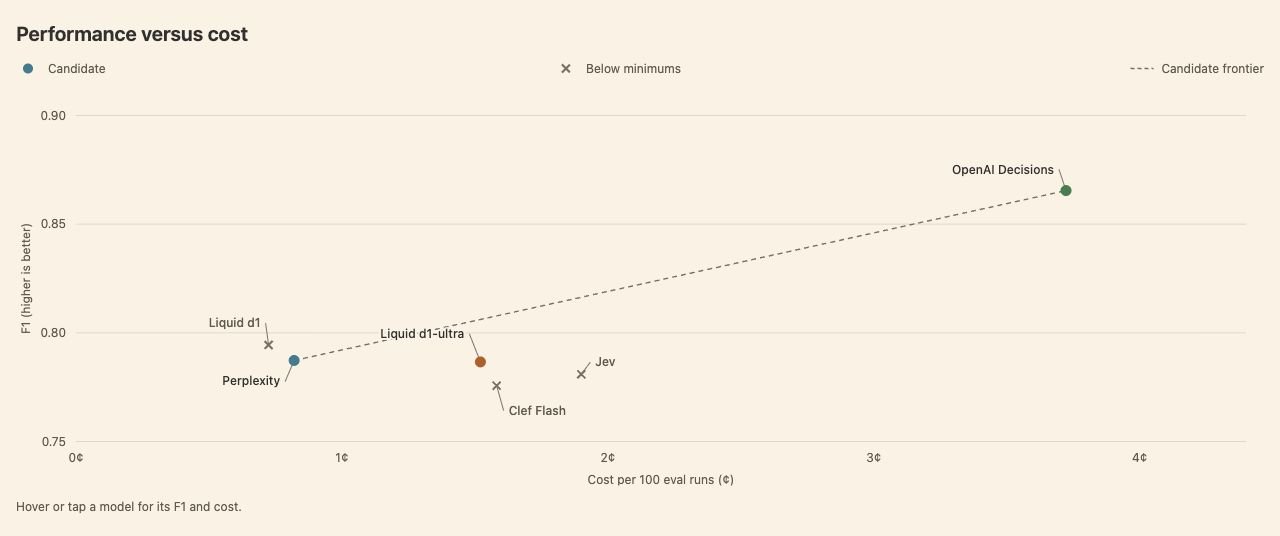
下方的图表比较了每个模型的 F1 分数(调整后)与成本,重点关注我们剩余的候选模型:
Explore the interactive chart on hamel.dev
虚线显示了剩余候选模型之间的帕累托前沿。对于任何给定的 F1 分数,它都能确定达到或超过该分数的最廉价候选模型。这张特定的图表看起来有些简单,因为只有三个选项,但它对于如何思考成本与性能的对比是一个有用的说明。
Perplexity 是这些候选模型中最便宜的,每 100 次评估运行花费 0.82 美分,F1 分数为 0.79。OpenAI Decisions 达到了 0.87 的 F1 分数,每 100 次评估运行花费 3.72 美分,成本大约是前者的 4.5 倍。
我们能信任这些概率吗?
除了通过/失败评估之外,你可能还想将决策模型的分数用作置信度估计。但是,你能从字面上理解这个数字吗?如果 0.80 的分数意味着 80% 的故障概率,那么大约 80% 具有相似分数的轨迹应该包含故障。
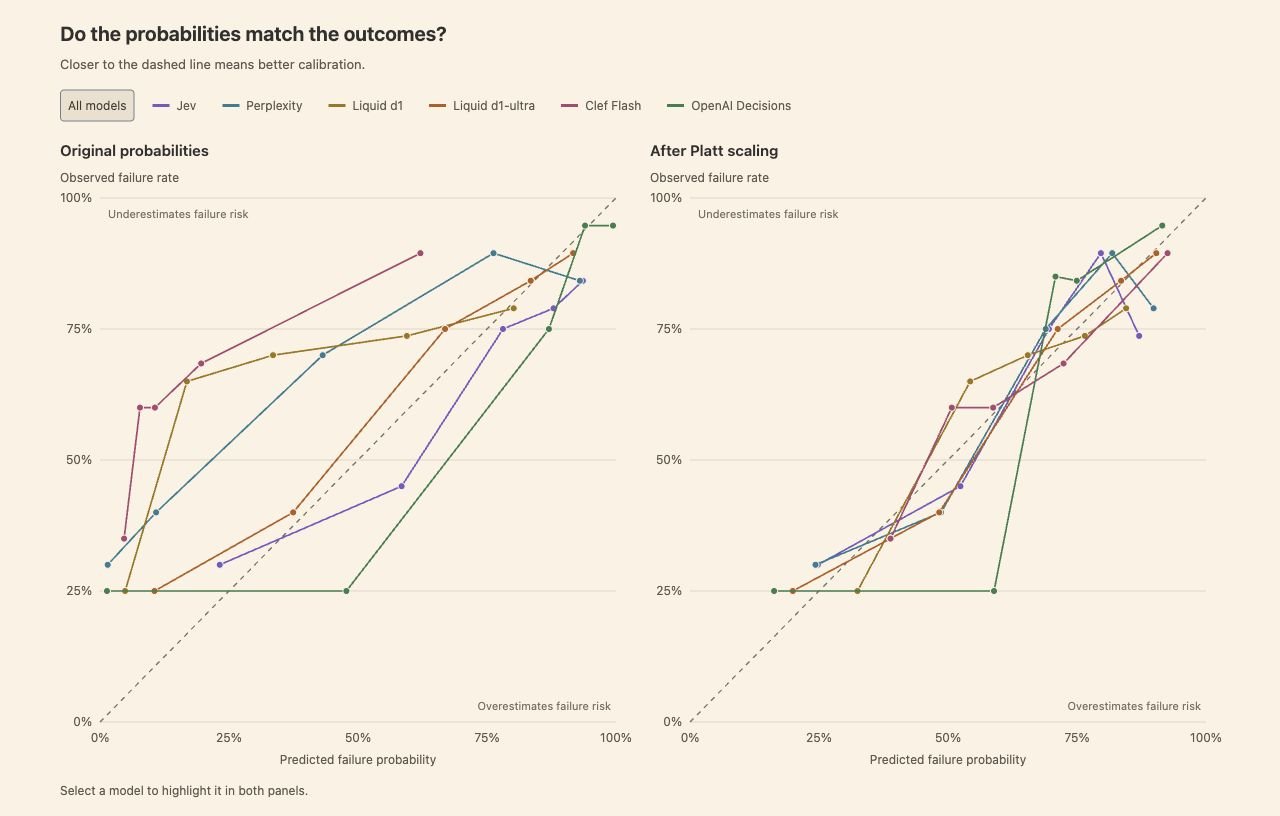
下方的图表展示了每个模型的概率校准:其预测概率与观察到的结果有多接近。每个点代表大约 20 条具有相似分数的轨迹。对角线上的点意味着预测概率与该组的故障率相匹配。在线上方,模型低估了故障风险。在线下方,模型高估了该风险。
如果预测概率与观察到的结果不匹配,我们可以使用另一个模型来调整它们。第二个面板展示了一种方法,即 Platt scaling,它通过拟合一条简单的曲线来进行调整。
Explore the interactive chart on hamel.dev
Perplexity、Liquid d1 和 Clef Flash 在校准后更接近对角线。例如,一组 Clef Flash 轨迹的平均预测故障概率约为 8%,但实际有 60% 包含故障。
Jev 和 Liquid d1-ultra 在这个数据集上已经校准得很好,几乎不需要调整。
Platt scaling 并不总是最合适的。例如,OpenAI 的概率在使用我们这版 Platt scaling 后变得稍微差了一些。你可以用以下提示词指导你的编程代理执行校准:
Using my saved failure probabilities and binary labels (1 means failure), test whether Platt scaling improves each model’s probabilities. Use stratified five-fold cross-validation with the same splits for every model. Fit the calibration mapping on each training split and apply it to the remaining traces. Fit on log-odds, clipping probabilities away from 0 and 1 first. Plot predicted probabilities against observed failure rates before and after calibration. Report Brier scores (lower is better), and explain which models improved or got worse. Reuse the saved scores without making new model calls.
提示词调整与评估器范围
我们在本文中保持了评估任务的宽泛性,以便更容易看出模型之间的差异。在实践中,我们建议为每种故障模式构建一个单独的评判器。在任务更窄、指导更具体的情况下,我们预计模型之间的性能差距会缩小。
我喜欢先从一个在任务上具有可接受性能的较大模型开始,然后尝试较小的模型,看看它们是否能以更低的成本匹配较大模型的性能。如果你有高质量的标签,提示词调整也会很有帮助。我在本文中讨论了如何编写一个好的评判器提示词。
将这些想法付诸实践
对于这个特定的数据集,OpenAI 以较高的成本实现了突破性的性能。Perplexity 和 Liquid d1-ultra 提供了成本更低、性能也更低的选项。我们观察到,模型性能在不同的任务和数据集之间差异很大,这意味着自己进行测量非常重要。
总结一下:
- 一旦你对评判器的提示词感到满意,就为你的用例设定最低的精确率和召回率要求。排除那些无法满足这些要求的模型。
- 在比较性能之前,调整每个模型的决策阈值。选择符合你业务目标的精确率-召回率权衡。要有目的性,不要仅仅因为本文使用了 F1 分数就去使用它!
- 如果你想将分数用作置信度估计,请检查概率是否与观察到的结果相匹配。校准可能会有所帮助,但你需要衡量它是否真的带来了改善。
- 根据你的工作负载权衡性能与成本和延迟的关系。
这个过程是迭代的。你可能会改进提示词,然后需要再次调整阈值或重新校准。在这篇文章中,我们重点关注阈值调整和校准,因为我们看到许多人在使用决策模型时直接开箱即用,而没有考虑这些因素。
你可能还想知道决策模型与 LLM 相比如何。OpenAI Decisions 使用了 GPT-6 Luna,它以最高的成本交付了我们最高的 F1 分数,这表明更难的评估任务可能值得为 LLM 支付更多费用。在更广泛的比较中,Randy Olson 发现决策模型可以在分类和路由方面以更低的成本匹敌 LLM,而 LLM 则在需要知识和推理的任务中脱颖而出。
本文讨论的想法都不是新事物。选择精确率-召回率权衡、调整阈值以及比较性能与成本,是评估任何分类器的一部分。要了解更多关于这些基础知识的内容,我推荐阅读 Kyle Gallatin 和 Chris Albon 编写的《Machine Learning with Python Cookbook, 2nd Edition》。
最后,如果你是一名数据科学家或机器学习工程师,想知道自己在 AI 时代的位置,这些技能你已经具备了。是时候“复仇”了 🙂。
P.S. 我会在我的时事通讯中分享此类文章以及我在构建 AI 产品方面的学习心得。要了解更多关于评估的内容,Shreya Shankar 和我合著了由 O’Reilly 出版的《AI Evals for AI Engineers》。
P.P.S. 这篇文章有很多脚注。你可以在 hamel.dev 上阅读它们。